机器人 “会做” 之后,下一步是 “会学”:清雁科技联合多家机构发布 ReAct-Manip 评测集
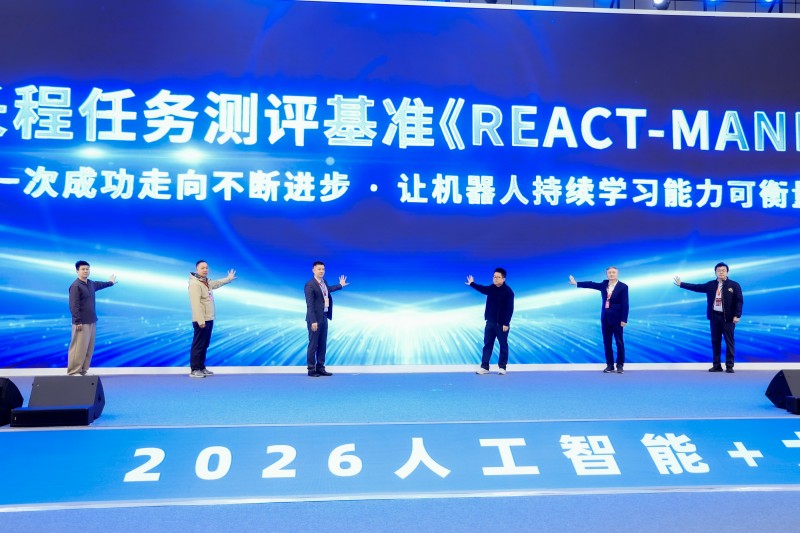
2026 年 10 月 31 日,在 2026 人工智能 + 大会主论坛上,香港中文大学(深圳)冀晓强教授、北京航空航天大学王理教授、深圳河套学院刘桂良教授、深圳市人工智能与机器人研究院(AIRS)具身智能中心主任刘少山、北京市人工智能协会、九源智能计算系统生态联合体与清雁科技(北京)有限公司联合发布《边做边学:物理 AI 操作适应能力评测集》(ReAct-Manip)。据发布方介绍,这是业内首个把评测焦点从 “能不能完成一次任务” 转向 “能不能在同一次任务中越做越好” 的机器人操作基准,试图把评测视角从任务完成能力进一步拓展到持续学习能力:面对此前未见过的物理实例,机器人能否在连续尝试中从行动反馈里积累经验,并将其转化为下一次尝试的改进策略。
会做,不等于会学
当前机器人操作基准从不同维度推动了领域发展,其评测重点各有侧重:RLBench 以 100 个手工任务和少样本挑战著称,Meta-World 聚焦多任务与元强化学习,CALVIN 用链式指令考验长程执行,LIBERO 则推动终身学习评测。
然而,完成任务的能力,不等于从交互中持续学习的能力。 在真实物理环境中,机器人面对的往往不是参数已知、条件固定的任务。同一个杯子,注水前后的质量和重心可能发生变化;同一块布料,褶皱状态会改变其接触与摩擦特性;同一个抽屉,滑轨阻尼的细微差异就可能让一次抓取从成功变为卡滞。机器人在真实世界中面对的从来不是一个 “参数已知的固定实例”,而是一个需要边做边感知、边感知边修正的物理过程。首次成功率能够反映模型在既有知识和当前策略下完成任务的能力,却难以回答另一个关键问题:当第一次尝试失败后,模型能否从失败中获取有效经验,并在后续尝试中做得更好?
ReAct-Manip 正是为评估这一能力而设计。通过不预先提供任务实例的关键物理参数,并允许模型在连续交互中积累经验,它将评测重点从单次任务完成能力,进一步延伸到模型能否利用交互反馈实现持续适应与性能改进。
不预先告知关键物理参数,让机器人连续尝试 15 次
ReAct-Manip 的核心设计是为每个任务用例设置特定的物理参数,包括摩擦系数、质量分布和物体尺寸。机器人难以仅凭单次观测准确推断这些条件,因此需要通过连续交互逐步积累经验,调整操作策略。每个用例包含15个回合测试,在15个回合中,前 10 次为练习,后 5 次为考试。模型需要根据每次操作的结果调整策略,评测则通过对15个回合的最终表现做评分和15次的分数变化,考察模型能否利用交互经验改进后续操作。
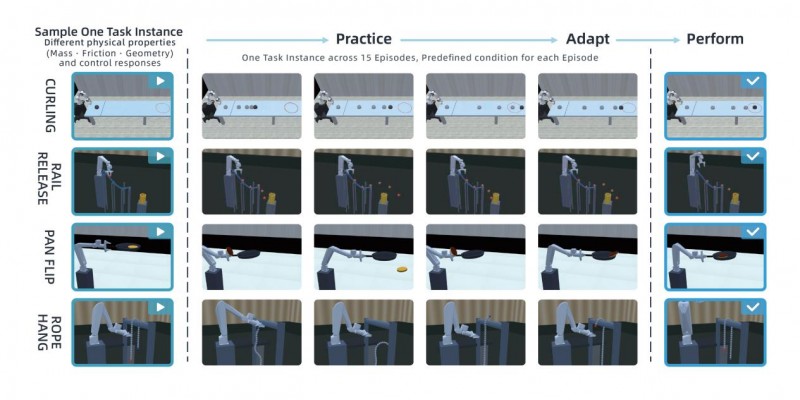
这套设计的关键在于,模型不能仅依赖预先给定的物理参数完成任务,更需要在行动、观察反馈和调整策略的过程中,逐步适应当前的物理条件,以取得最佳的操作结果。例如,在 “竖手机” 任务中,机器人需要从若干道具中选择支撑物,让手机稳定竖立。道具的质量和摩擦无法从初始画面准确估计,看似合适的支撑物可能在接触后让手机滑落。机器人必须观察每次尝试的结果,调整道具选择、摆放角度或接触位置。
在规模上,ReAct-Manip 覆盖16 类模拟操作任务,涵盖接触操作、动态释放、工具使用等场景,当前评测库从每类任务中选取 3 个实例,共48 个固定实例、720 个回合。所有实例与回合状态均可复现。评测入口与代码已通过项目官网开放。
初步结果:GPT-6展现任务完成能力,持续适应仍有提升空间
在目前公开的测试结果中,GPT-6 Astra + primitive Harness 在 ReAct-Manip 练习阶段480次尝试中成功 177次,成功率为 36.88%;考试阶段240次尝试中成功 130次,成功率提升至54.17%,考试综合得分为 52.62。结果表明,GPT-6结合执行框架的通用模型已经能够完成部分操作任务,但面对精度要求高以及动态程度较高的长程复杂任务,距离稳定、可靠地完成仍有提升空间。
在15次回合测试中,GPT-6 Astra完成一项任务平均消耗超过1400万Token,单任务平均成本约105美元,单任务耗时仍难以满足实际应用要求。这表明,物理AI在推理效率、成本和响应速度方面仍有很大的优化空间。
ReAct-Manip 关注的不只是最终分数,更是模型能否把交互中获得的经验带入后续尝试。练习与考试阶段的成绩可以提供初步信号,但仅凭两个阶段的成功率,还不足以将表现变化完全归因于持续学习。要进一步判断模型是否真正从经验中获益,还需要结合保留历史与清除历史等对照分析,区分模型原有的任务能力、即时调整能力,以及能够跨回合保留和利用经验的能力。
让“边做边学” 成为物理 AI可比较的公共标尺
机器人进入真实环境后,面对的往往不是参数已知、条件固定的任务,而是需要通过行动逐步摸清物理规律、根据反馈修正策略的动态过程。模型能否一次完成任务固然重要,但当第一次尝试失败后,它能否从结果中提取有效信息,并在下一次做得更好,同样决定着系统能否适应真实世界。David Silver与Richard Sutton在《Welcome to the Era of Experience》中提出,智能体应更多地从与环境交互产生的自身经验中持续学习;Ilya Sutskever也在访谈中强调部署后通过试错进行持续学习的可能性。这些判断指向同一个方向:下一代机器人的核心竞争力,可能不再只是“一次做对”的先验能力,而是“做错之后越做越对”的经验能力。ReAct-Manip 希望把这一能力从模糊的技术期待,转化为可复现、可比较、可持续迭代的公共评测问题,推动行业更加重视物理 AI 的持续学习能力。作为ReAct-Manip的发起方,清雁科技(北京)有限公司由清华大学与北京雁栖湖应用数学研究院联合孵化,是北京市“专精特新”及国家级高新技术企业。公司聚焦物理AI底层创新,打通“底层数学理论-物理AI模型-数据基础设施”全链路自主创新体系。着力解决物理AI高效性和永续自主学习等核心难题,为ReAct-Manip等评测基础设施的持续研发与生态运营提供支撑。
评测基准、任务说明及相关代码已通过项目网站开放。我们诚挚邀请高校、科研机构和产业团队参与评测、提交结果、共同完善榜单,也欢迎大家基于公开协议复现和检验模型表现。让不同技术路线在统一、透明的标准下接受检验,一起回答一个关键问题:机器人不仅能不能做对,更能不能在一次次交互中持续学会做得更好。
(审核:支艳蓉)